mercredi 11 juin 2008

Encyclopédie

Après les remarques à l'emporte-pièce d'Andrew Keene, voici enfin un ouvrage qui donne quelques pistes pour mieux comprendre Wikipédia: Quand le citoyen lambda devient encyclopédiste. Wikipédia. Média de la connaissance démocratique. Même s'il n'a qu'un auteur, Marc Foglia, ce dernier intègre dans le texte des contributions d'autres personnes, ce qui en fait un livre collaboratif.
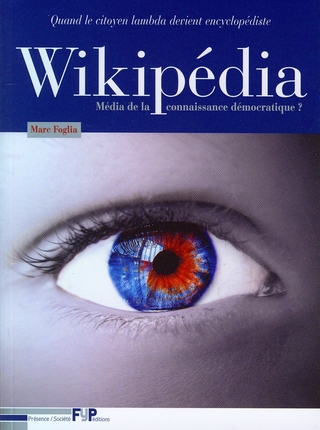
Quand le citoyen lambda devient encyclopédiste. Wikipédia. Média de la connaissance démocratique.

Ce livre commence par tracer des parallèles entre Wikipédia et les projets encyclopédiques des Lumières. Les auteurs des articles étaient inconnus et ne signaient qu'avec leurs initiales. L'Encyclopédie de Diderot et d'Alembert avait pour but de propager la connaissance chez l'honnête homme. Il ne s'agit donc pas de ce qu'on appelle de "connaissances chaudes", encore proches des débats scientifiques, mais de "connaissances froides". Peut-on définir des tendances politiques marquant le projet wikipédien? L'auteur y voit un mélange intéressant de pensée libérale (liberté d'expression) et de collectivisme. Il met aussi en avant le fait que Wikipédia, c'est aussi (et peut-être avant tout) une communauté. Au-delà des articles, il y a des discussions, des dialogues, des personnes qui se connaissent.

L'auteur pose aussi la question de la nature de la connaissance dans Wikipédia. L'ensemble donne une impression de joyeux fatras, mêlant des sujets tendance (par exemple à propos de "people") et des sujets sérieux. A l'intérieur d'un article, l'anecdotique le dispute parfois à des informations plus fondées. Le fait que Wikipédia soit issu d'un travail collectif y est pour quelque chose: en l'absence de projet éditorial réel et de contrôle, c'est le consensus qui l'emporte. En fait, les connaissances disponibles dans Wikipédia en disent plus sur la communauté des wikipédiens (et probablement sur la société dans son ensemble) que sur l'état des connaissances de notre époque.

Wikipédia est l'un des projets qui montre le mieux que les rôles d'auteurs, d'éditeurs et de lecteurs ne sont plus aussi bien séparés sur Internet que dans le monde de l'imprimé: les lecteurs peuvent en effet modifier, corriger l'encyclopédie qu'ils consultent. Une fois de plus, c'est la notion d'auteur qui est remise en question.

L'auteur pose aussi la question de la connaissance apportée par Wikipédia. Google et Wikipédia forment un duo omniprésent dans le domaine de la recherche d'information sur le Net: l'internaute commence par une requête sur Google qui l'amène invariablement vers un article de Wikipédia. Quelle que soit la qualité de l'article trouvé. La connaissance est consommée de manière immédiate, sans regard critique, sans recul. On peut parler de malinfo (terme forgé sur malbouffe). C'est peut-être ce qui manque le plus dans Wikipédia: l'encyclopédie se veut neutre, évite toute connaissance faisant l'objet d'un débat. Il y a donc de gros doutes sur l'apport de Wikipédia dans le domaine de l'éducation.

Le livre se termine par un sondage intéressant effectué en France à propos de Wikipédia. On y apprend que 92% des internautes interrogés ont une bonne opinion de Wikipédia et que 74% ont confiance dans ses articles. Comme quoi, l'encyclopédie collaborative, malgré ses défauts, a encore de beaux jours devant elle.

mardi 3 juin 2008

Dématérialisation?

Il n'y a pas si longtemps, on ornait encore les albums photos de nos vacances lointaines avec son billet d'avion ou sa carte d'embarquement. Les albums ont disparu avec les photographies numériques. Et maintenant c'est le billet d'avion qui se volatilise. Ce bout de papier qui nous angoissait tant: il ne fallait pas l'oublier avant de partir, ni le perdre ou se le faire voler pendant le voyage. Le voilà réduit maintenant à quelques bits dans une boîte électronique ou dans un téléphone portable. En effet, depuis le 1er juin, l'IATA oblige les compagnies d'aviation à émettre des titres de transport non matériels, permettant de faire des économies évaluées à 3 milliards de dollars. La plupart des compagnies sont prêtes et celles qui n'ont pas pas encore pu s'adapter recourent aux services de celles qui le sont.

http://www.iata.org/pressroom/pr/2008-31-05-01.htm

La tendance à la matérialisation et à la virtualisation continue à se développer, qu'il s'agisse d'argent, de titres de transport ou même de relations sociales. Cette évolution est d'autant plus frappante que la réalité matérielle revient frapper à notre porte, sous la forme des crises énergétique et alimentaire. Les compagnies aériennes n'émettent plus de billets en papier, mais leur facture de pétrole est bien réelle et le ticket virtuel n'en sera guère allégé...

dimanche 25 mai 2008

Je sème à tout vent

La fameuse devise du dictionnaire Larousse invite à la diffusion du savoir. Il faut admettre qu'Internet joue un rôle de plus en plus prépondérant dans la recherche d'informations et de connaissance. C'est en tout cas ce que laisse penser le fait que le moteur de recherche Google et l'encyclopédie collaborative Wikipédia soient parmi les sites les plus consultés.

http://www.comscore.com/press/data.asp

L'encyclopédie Wikipédia constitue de fait un véritable défi pour les encyclopédies traditionnelles. Ces dernières ont des contenus produits par des spécialistes et passant par divers contrôles de qualité. Elles ont fait une première mutation sur CD-Rom, il y a quelques années déjà. Le CD-Rom ne posait pas de problème de monétarisation. En revanche, la mise en ligne est plus complexe. Les principales encyclopédies proposent un abonnement:

http://www.oxfordreference.com/

http://info.britannica.co.uk/

http://www.universalis.fr/

Mais Wikipédia offre ses contenus gratuitement et, de surcroît, elle permet aux internautes de participer aux contenus. C'est certainement ce qui a incité Larousse à proposer le contenu d'une encyclopédie gratuiteme en ligne et à inviter tout un chacun à contribuer à son enrichissement. Le site Internet de l'encyclopédie comporte (ou comportera prochainement) même des fonctionnalités visant à instaurer une certaine collaboration entre les contributeurs. Les articles des internautes font aussi l'objet de votes.

Larousse

http://www.larousse.fr/

Si l'on compare Wikipédia et Larousse, on a deux modèles différents de collaboration.

- collaboration totale et partielle: Larousse offre potentiellement deux séries d'articles, ceux qui ont été composés par des experts et ceux des internautes. Wikipédia ne fait pas une telle distinction et mise sur l'intelligence collective pour l'amélioration de ses contenus.

- dans le cas de Larousse, chacun conserve la maîtrise de ses contenus, aussi bien les experts que les contributeurs libres. Une fonctionnalité permettant de proposer des modifications est cependant prévue pour les articles des contributeurs.

Il sera intéressant de voir si un mode de collaboration qui reconnaît encore un auteur à une contribution dans l'encyclopédie, même si cet auteur finit par bénéficier des informations d'autres internautes, suscite un intérêt. On quitte un peu le monde de la collaboration pour entrer dans celle de la participation. On peut d'ailleurs se demander qu'est-ce qui motivera les lecteurs à signaler des erreurs ou des améliorations dans un article de Larousse, alors que Wikipédia les autorise à intégrer les corrections eux-mêmes. C'est finalement le choix du contributeur qui sera déterminante: souhaite-t-il voir son texte être modifié (jusqu'à devenir méconnaissable) ou préfère-t-il composer un texte qu'il juge lui-même digne de publication et que seul le vote des internaute viendra sanctionner?

dimanche 18 mai 2008

Les amateurs

Un des livres qui a nourri le débat à propos du Web 2.0 porte un titre qui ne laisse aucun doute sur le parti-pris de son auteur: “Le Culte de l’amateur. Comment Internet détruit notre culture?”. Andrew Keen livre une critique impitoyable sur l’Internet d’aujourd’hui, se désolant de ce qu’on laisse le champ libre à des amateurs, alors que les positions de certains professionnels comme les journalistes, les libraires, les éditeurs de musique, sont de plus en plus fragilisées. Il regrette que les personnes de talent soient concurrencées par des amateurs, sans toutefois définir ce qu’il entend par talent. Même pour le terme amateur, l’auteur se contente d’une définition dictionnaire, sans chercher à savoir qui sont ceux qu’il nomme amateurs et pourquoi ils contribuent aux contenus d’Internet. Seuls les professionnels sont, à ses yeux, capables d’un travail sérieux. L’auteur défend un point de vue corporatiste et, de surcroît, il confond l’ensemble du Web participatif avec Wikipédia, le site dans sa ligne de mire. Il omet de mentionner le mouvement open source qui est le modèle de base pour la collaboration en ligne. Il ne fait pas la différence entre la collaboration où chaque participant est sur pied d’égalité (Wikipédia) et le crowdsourcing, c’est-à-dire le fait que l’on confie une tâche précise à une foule de personnes. Nous avons donné dans ce blog plusieurs exemples de projets de nature scientifique où des tâches sont confiés à une multitude de passionnés:

On pourrait encore mentionner ce site de crowdsourcing visant à traduire une encyclopédie rédigée en grec et datant de l’époque byzantine:

En fait, la limite entre amateurs et professionnels se fait de plus en plus ténue sur Internet. On compte parmi les blogueurs de nombreux professionnels qui parlent des sujets dont ils sont spécialistes, partageant leurs réflexions avec leurs pairs. Ils ont la compétence des professionnels, mais ils ne sont pas rétribués directement pour leur blog, qui fait plutôt partie de leur “self-marketing”.

Pour revenir au terme “amateur”, n’oublions pas qu’il vient du latin amare (aimer) et qu’il désigne quelqu’un qui a un goût vif pour quelque chose, quelqu’un qui cultive les beaux-arts sans en faire sa profession (musique, peinture) et, en mauvaise part, un homme d’un talent médiocre. Andrew Keen retient la dernière définition, alors que dans le domaine du Web collaboratif, c’est la seconde qui s’impose. De nombreuses personnes entretiennent et développent des compétences dans un domaine sans que cela devienne une profession, soit parce qu’ils ont découvert ce domaine a après leur formation, soit parce qu’ils l’ont étudié mais n’ont pas pu l’exercer professionnellement. De surcroît, il existe de nombreux domaines où mondes professionnels et amateurs coexistent sans que cela pose problème, comme le sport. Enfin, il faut peut-être retourner un peu dans le passé pour réaliser que la professionnalisation de la science est relativement récente. De nombreux domaines scientifiques doivent une partie de leur développement à des amateurs, au bon sens du terme.

Andrew Keen consacre de nombreuses pages de son livre à pleurer sur la mort ou la longue dégénérescence des industries du livre et de la presse, de la musique et du cinéma. Il attaque au passage le concept de longue traîne de Chris Anderson, sans toutefois livrer son argumentation (traiter une théorie d’utopique ne suffit pas). On commence toutefois à sortir de ce qu’on peut considérer comme le Web 2.0 stricto sensu. Il s’agit plutôt d’une révolution dans le mode de distribution de certains produits. Si le Web 2.0 y est pour quelque chose, c’est uniquement dans le phénomène des recommandations: les internautes ont la possibilité de créer des notices où ils donnent leur avis sur tel ou tel produit. Autrefois, les critiques faisaient les succès. Aujourd’hui ce sont les commentaires des internautes et les blogs. La longue traîne, plus qu’un modèle à suivre, est une constatation faite sur l’observation des ventes de livres dans Amazon. La distribution d’ouvrages ou de CD via Internet s’avère plus efficace, car elle met un produit à disposition de son public potentiel grâce aux mots-clés. Sur le fond et notamment sur la question de la propriété intellectuelle mise à mal par le Web actuel, de nombreux auteurs ont déjà mis en évidence le fait qu’elle devait être revue.

Andrew Keen se défend de vouloir jeter le bébé avec l’eau du bain, ayant lui-même travaillé dans la Silicon Valley. Pourtant c’est bien ce qu’il fait. Son propos devrait se restreindre à ce qu’on appelle Web 2.0 ou Web participatif: la blogosphère, Wikipédias, etc. Mais il critique bien d’autres facettes d’Internet qui n’ont rien à voir avec la participation, comme les jeux d’argent en ligne ou les problèmes de sécurité. En ce qui concerne la critique de ce qui constitue exclusivement le Web 2.0, à savoir la participation et la collaboration, son argumentation est bien faible. Surtout, il ne met pas en balance les avantages (coût, mobilisation) avec les inconvénients (qualité, crédibilité). Le Web participatif et collaboratif doit encore mûrir. Mais quand on voit l’évolution de Wikipédia, qui a peu à peu mis en place diverses systèmes pour améliorer sa qualité, on est en droit de croire que c’est possible.

Ce que ce livre ne dit pas (ou trop peu), c’est la profondeur des changements qui sont en train de se produire. Les utilisateurs d’Internet ne veulent plus être passifs comme l’étaient les lecteurs des journaux papier. Ils veulent participer aux contenus. Mais il existe plusieurs degrés de participation, du commentaire à la co-création. Chacun finira par trouver sa place, qu’il soit amateur ou professionnel.

samedi 10 mai 2008

Nuage de mots-clés

Le nuage de mots-clés (ou tags cloud) s’est imposé comme mode de visualisation des contenus d’un site Web, soit à partir des mots utilisés dans le site, soit à partir des mots-clés déterminés par les auteurs du site ou encore à partir des termes utilisés dans le moteur de recherche. Il met en évidence les termes les plus courants grâce à un agrandissement proportionnel à leur incidence. Ce mode de visualisation a été popularisé notamment par des sites comme Flickr. Le nuage de mots-clés permet de prendre connaissance du contenu d’un site en un clin d’oeil, de voir les thèmes principaux abordés et aussi d’accéder aux pages où se trouvent les mots en question.

De nombreuses applications de publication sur Internet, comme les blogs, offrent cette fonctionnalité. Certains sites offrent également la possibilité de générer des nuages de mots et de les intégrer. Le nuage ci-dessus a été créé à partir du site http://web.mozbot.info/. Il s’agit cependant d’une copie d’écran, car WordPress ne reprend pas le code correctement. Ce site offre la possibilité de paramétriser le nuage de mots-clés, en choisissant les termes que l’on souhaite montrer dans une liste exhaustive, les couleurs, le nombre d’occurence minimale. Il est aussi de générer des expressions (comme “musée virtuel”) Ce qui manque en revanche, c’est d’associer les termes correspondant à une même entrée dans le dictionnaire: virtuel, virtuelle, virtuels, virtuelles apparaissent séparément. De plus, d’après les tests effectués, seule une page est prise en compte.

lundi 28 avril 2008

Lectures multiples


Le Web est virtuel. C’est presque un truisme que de le dire. On peut cependant s’interroger sur le fonctionnement de cette virtualisation. Un des éléments fondamentaux du Web est le langage qui le code: HTML ou Hypertext Markup Language. Il s’agit d’un langage descriptif: il permet s’insérer certains éléments entre deux balises indiquant leur nature. Par exemple, un titre principal est indiqué avec la balise h1:

<>Titre< / h 1 >

Ce langage donne essentiellement des indications concernant le style: titre, paragraphe, gras, italique,… Il permet aussi d’intégrer certains éléments comme les liens hypertextes et les images.

Ces balises sont invisibles pour l’internaute. Il ne voit que le résultat produit par son navigateur Internet. Chacun a pu remarquer que des navigateurs différents interprètent parfois autrement le code HTML. Mais les navigateurs ne sont pas les seuls logiciels qui lisent et interprètent le code HTML. Il y a aussi les logiciels permettant de lire les fils RSS ou les logiciels lisant à haute voix (de synthèse) les pages pour les non-voyants. Que cela signifie-t-il? A partir du moment où l’on peut un texte au format HTML, on ne maîtrise plus la lecture qui en est faite, car cette lecture n’est pas directe, mais se fait via un interpréteur. C’est le développeur de l’interpréteur qui décide de la manière dont une balise est rendue. Ainsi si je regarde ce même blog avec un lecteur de fils RSS, je le vois complètement différemment:

De nombreux lecteurs le voient ainsi et ne peuvent pas savoir si j’en ai changé l’apparence.

La lecture nous échappe donc, contrairement à ce qui se passent dans le monde de l’imprimerie. Cette lecture se virtualise dans la mesure où c’est le contenu qui va au lecteur et non plus le lecteur qui visite le site.

De nombreux outils parcourent le Web et lisent le code HTML: les moteurs de recherche, les aggrégateurs. Nos contenus apparaissent, entièrement ou sous forme de teasers, dans d’autres sites. Ils se virtualisent et il faut l’apprécier, car c’est ainsi qu’ils se font connaître des lecteurs.

vendredi 18 avril 2008

Faire une bibliographie en un clic

On parle beaucoup du Web sémantique. Ce concept reste néanmoins théorique aux yeux des non-spécialistes. Depuis peu, cependant, il est possible d’en trouver des applications qui, faute d’être parfaites, ont le mérite de nous montrer tout l’intérêt d’un web qui comporte des méta-données, c’est-à-dire des informations à propos des informations qu’on y trouve. Si l’on indique, par exemple, que les caractères “Jean Dupont” désignent un nom de personne, cela permettrait de retrouver plus facilement des personnes.

Depuis peu, un outil permettant le traitement et l’indexation des données est disponible librement. Il s’agit d’Opencalais, une technologie rachetée par Reuters et mise à disposition de tous gratuitement. Plusieurs applications sont désormais accessibles au public.

Parmi ces applications, l’une va permettre à l’utilisateur de réunir une liste d’ouvrages disponibles dans Amazon à partir d’un sujet décrit dans Wikipédia. Notons d’emblée que cela n’est possible que parce que les trois systèmes impliqués (Amazon, Wikipédia et Opencalais) sont ouverts aux développeurs qui souhaitent les intégrer à leurs applications.

Que fait le système en question? Quand on entre un terme, il recherche la notice dans Wikipédia et l’analyse. Il en tire une liste des termes essentiels. Il va ensuite dans Amazon pour rechercher les mots-clés correspondant et, s’il y a en a, les ouvrages qui traitent du sujet. En un seul clic, on parvient à obtenir une liste de livres disponibles sur un thème, simplement en exploitant des données déjà existantes.

Bien entendu, le résultat n’est pas encore parfait et les sources de l’imperfection peuvent provenir des trois systèmes. Les articles de Wikipédia sont de qualité inégale et pas toujours bien structurés. Amazon est une librairie en ligne et non pas un outil bibliographique. En ce qui concerne l’outil d’analyse, il génère une liste de termes-clés au moyen d’un algorithme. Dans le domaine du Web sémantique (on l’a déjà vu avec les images), il y a deux options: automatisation via des programmes ou recours à l’intelligence humaine via le crowdsourcing. Les deux méthodes ont leurs avantages et désavantages. Cependant la masse des données déjà disponibles sur Internet rend presque indispensable l’utilisation de programmes d’analyse des données.

http://kapustar.punkt.at/labs/knowledgelounge.org/

lundi 14 avril 2008

Structuration de données collaborative

Dans une encyclopédie, les connaissances sont présentées sous forme d’articles reliés entre eux par des liens ou des mots-clés. Il ne s’agit pas de données structurées. Les encyclopédies se prêtent donc bien à une transposition sur Internet sous forme de wiki, c’est-à-dire un système d’hypertexte collaboratif.

Depuis peu, les données structurées sont aussi devenues compatibles avec le Web 2.0. Il s’agit de données organisées selon un système hiérarchique et avec, pour chaque donnée, des informations obéissant à une certaine structure, des banques de données en somme. Il est désormais possible de publier des données et de participer à leur structuration sur le site Freebase.

http://www.freebase.com/

Sur ce site, il est possible (pour peu que l’on ait ouvert un compte gratuit) de:

  • ajouter des données à des séries déjà existantes. Le système compte actuellement plus de 20′000 livres, 38′000 films, 5000 bâtiments, 1000 vins et 60 fromages (là il y a encore un grand effort à faire).
  • discuter de questions concernant la structuration des données. Parmi les discussions en cours, on peut en relever une consacrée aux types de musées.
  • structurer les données

Freebase est aussi un système ouvert vers l’extérieur. Il est possible d’en réutiliser les données dans des applications, des sites web, des widgets. Parmi les réussites, on peut noter certaines réalisations:

  • Archiportal : Les bâtiments listés et décrits dans Freebase sont représentés sur une carte (Google Map)

    Bâtiments de la ville de Rome présents dans Freebase
  • History of sciences : une frise chronologique présentant les savants qui ont joué un rôle important dans le développement de la science, d’Anaximandre à nos jours. Un lien permet de retourner sur la notice complète dans Freebase.

Ces deux exemples montrent bien que l’un des enjeux du Web actuel est l’interopérabilité entre systèmes. Cela permet de créer des visualisations performantes des données, sur une échelle de temps ou une carte de géographique. Chacun trouve son rôle dans un prochain: ajouter des données, programmer des interfaces, etc …

Cette étape de la structuration des données me semble essentiel. Des quantités incroyables de données ont été numérisées et mises à disposition sur Internet. Il faut maintenant s’occuper de leur gestion. Freebase se nourrit de Wikipédia, car il reprend de nombreuses descriptions, mais il offre une dimension supplémentaire: une hiérarchie , un classement des données.

mardi 8 avril 2008

Les expositions imaginaires du Louvre

Le site Internet du Louvre innove en offrant des expositions en 3D, intitulées “Expositions imaginaires”. Pour l’instant, on peut en admirer trois.

Une salle du Louvre est restituée dans son état de 1913. Elle rassemblait la collection léguée par Louis la Caze. Ces chefs-d’oeuvre sont maintenant dispersés dans le musée. D’où l’intérêt de cette exposition. Les technologies 3D permettent en effet de garder une trace dynamique d’anciens états du musée, offrant une meilleure interactivité que les images. Certains tableaux sont cliquables et permettent d’ouvrir une notice (fonctionnalité qui ne fonctionne pas sur mon Mac).

On peut aussi voir une réunion des oeuvres de Fragonard. Les tableaux sont répartis dans plusieurs salles qu’il est possible de visiter. Là aussi des notices sont disponibles.

Une reconstitution d’une église copte d’Egypte permet de visualiser ce que des fouilles archéologiques ont permis de savoir sur l’histoire de l’édification du bâtiment. On peut découvrir aussi bien l’intérieur que l’extérieur de l’église. Certaines zones sont cliquables. Grâce à un touche, il est possible de voir un autre état de construction de cette église.

Ces visualisations 3D sont accessibles sur le site du musée. Il faut télécharger le plugin 3D Life Player pour lire ces fichiers créés avec Virtools. On navigue dans les reconstitutions 3D à l’aide de la souris ou des touches. On est loin des mondes persistants dans lesquels on peut entrer avec un avatar. L’avantage de la technologie choisie est cependant qu’elle permet l’insertion dans un site Internet, bien qu’elle nécessite l’installation d’un plugin. Elle est donc facilement accessible.

En fait, ce type d’application existe depuis longtemps. Les enjeux de leur utilisation sont à la fois la simplicité d’utilisation pour les visiteurs d’un site et la facilité de mise en oeuvre. Sur les deux plans, des projets importants ont été réalisés ces derniers temps. De plus, le parc informatique a maintenant la puissance nécessaire pour populariser la 3D. Enfin, la 3D devient un référentiel naturel pour un public de plus en plus important: il s’agit notamment de ceux qui, jeunes ou moins jeunes, ont pratiqué les jeux vidéos. Les musées peuvent donc tirer un parti intelligent des possibilités de la 3D.

http://www.louvre.fr/llv/dossiers/liste_ei.jsp?bmLocale=fr_FR

vendredi 4 avril 2008

L’important, c’est de participer

En cette année olympique, la fameuse devise de Pierre de Coubertin est à la mode. Pourtant on ne voit plus guère d’athlètes qui se se rendent aux J.O.”pour participer”. Seule la performance compte maintenant. En revanche l’adage du baron pourrait s’appliquer à Internet.

On parle beaucoup de participation sur le Net, qu’on désigne par l’expression Web 2.0. On l’assimile souvent au narcissisme de la blogosphère ou au culte des amateurs qui aurait cours dans Wikipédia. La participation est cependant un phénomène beaucoup plus complexe. Je me souviens que la première fois que j’ai créé un article dans Wikipédia, je m’étais contentée de composer le texte. Quand je suis revenue voir mon article, quelques jours plus tard, j’ai eu la surprise de constater que quelqu’un avait intégré les liens vers d’autres articles de l’encyclopédie. Cette anecdote montre que la participation ne se confond pas complètement avec la création de contenus. Elle comporte aussi la gestion de ces contenus. En effet, sur les sites participatifs, à côté des auteurs, il y a une foule de petites mains qui corrigent, indexent, améliorent, illustrent les contenus. On trouve aussi des modérateurs volontaires, des numérisateurs de données qui donnent de leur temps pour mettre à la disposition des textes tombés dans le domaine public, des tableaux, des photos. Ces gens n’ont pas de nom, tout au plus un pseudonyme. On ne les remercie jamais. Pourtant, c’est en partie grâce à eux qu’en effectuant une recherche dans un moteur de recherche, on trouve un résultat probant. Si le Web avait dû compter sur des projets officiels, privés ou publics, jamais il ne se serait rempli aussi vite.

Internet est en train de vivre le retour de l’esprit des cathédrales. Cela peut surprendre à notre époque, si empreinte d’individualisme. C’est du reste peut-être par réaction à l’isolement social que cette participation se développe. En travaillant ainsi à un corpus universel des connaissances, on peut se sentir valorisé, même si les fruits de ce travail ne se récoltent pas immédiatement. On a l’impression de participer à une entreprise qui nous dépasse, de poser une modeste pierre sur un édifice essentiel. L’humain a certainement besoin de ce sentiment.

On considère habituellement que les grandes pyramides d’Egypte ont été construites non pas par des esclaves, mais par des hommes libres, en dehors des périodes où ils travaillaient dans leurs champs. On peut se demander qu’est-ce qui les poussaient à s’astreindre à une telle entreprise, d’une extrême pénibilité vu les moyens techniques de l’époque. Il semble que la construction de ces grandes pyramides soit liée à un culte solaire dans lequel le pharaon jouait un rôle essentiel (comme représentant du dieu soleil). Il y avait là une vision partagée par tout un peuple. La construction de la pyramide ne constituerait donc pas l’asservissement des hommes à l’ambition d’un tyran, mais la manifestation d’une conception du monde. En participant à la construction, ces hommes, dont on a oublié le nom, faisaient surgir un édifice qui devait dépasser leur destin singulier pour traverser les siècles. En cela, leurs attentes n’ont pas été déçues, puisque depuis 40 siècles, ces pyramides témoignent de leur passage sur terre.

Pyramides

Aujourd’hui il n’est plus question de traîner des blocs de pierre sur les rampes qui entourent une pyramide. Mais sait-on combien de temps prend la numérisation de livres entiers, de poèmes, d’images? Malgré les scanners, il y a encore beaucoup de travail manuel. Pense-t-on aussi au temps passé par des particuliers à administrer leurs serveurs pour que des internautes puissent venir y glâner des informations? Imagine-t-on le mal que se donnent tous ceux qui contribuent à gérer, améliorer ce que d’autres ont mis? Non seulement tout ce travail n’est pas rétribué, mais bien souvent il coûte encore de l’argent à tous ces inconnus qui enrichissent le Web. C’est donc à juste titre que Time Magazine avait attribué le titre de personnalité de l’année à cette foule d’anonymes. Même si ces derniers n’attendent pas de récompense.